
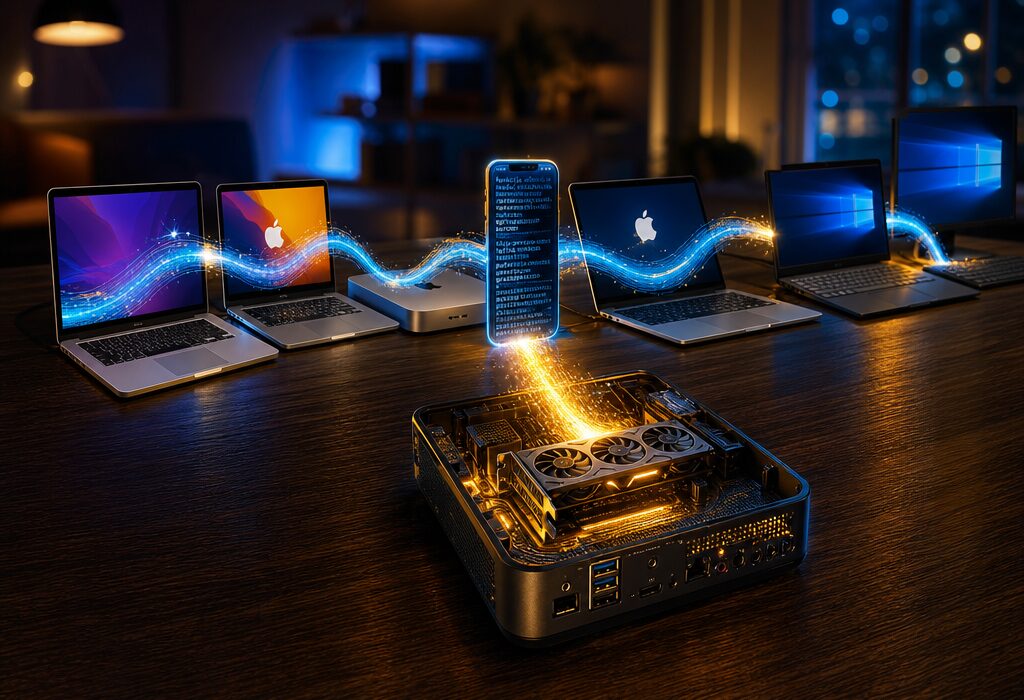
Model gpt-oss-120b ima oko 117 milijardi parametara i sam po sebi zahtijeva najmanje 80 GB memorije, koliko nosi cijela grafička kartica namijenjena data centrima. Nijedan od uređaja koje je ovaj entuzijast imao kod kuće nije mogao samostalno učitati toliki model, pa ga je razdijelio na komade i rasporedio po lancu.
U pogonu su završili Samsung Galaxy S24+, tri Maca i dva Windows računala. Rezultat radi, ali generira svega 1,1 token u sekundi. Za rečenicu od dvadesetak riječi treba dvadesetak sekundi. To je brzina kojom se ne može voditi razgovor s chatbotom, ali dovoljna da se dokaže koncept.
Kako je model raskomadan
Prije raspodjele, memorijski otisak modela smanjen je na 47 GB. Zatim je primijenjen takozvani pipeline parallelism: model je razrezan po slojevima, a svaki uređaj drži svoj dio. Mini PC nazvan „Tiny”, s Nvidia RTX 3060 i 12 GB memorije, nosi oko 28,7 GB modela — više od polovice. Ostatak se dijeli među Galaxyjem S24+, prijenosnikom s Windowsima i 12 GB memorije, MacBookom Pro s Intel procesorom, Mac minijem i MacBookom Pro M3.
Svaki token mora proći kroz sve uređaje redom, preko lokalne mreže, prije nego što se izračuna sljedeći. Lanac nikada nije brži od svog najsporijeg dijela. Tu leži cijena ovakvog pothvata: distribuirana inferencija na potrošačkom hardveru funkcionira, ali sporije od jednog dobro opremljenog stroja.
OpenAI je gpt-oss-120b objavio 5. kolovoza 2025. s težinama koje se slobodno mogu preuzeti. Model se oslanja na arhitekturu „mješavine stručnjaka” (mixture of experts): za svaki token aktivno je samo 5,1 milijardi parametara, dok ostatak miruje. Zato dijelovi koji se rijetko koriste mogu boraviti u sporijoj radnoj memoriji, a da to ne uruši cijeli sustav.
Što ovo govori o pristupačnosti AI-ja
Za one koji ne žele slagati šesteročlani klaster, OpenAI nudi i manji gpt-oss-20b koji prema tvrtki staje u 16 GB memorije. Razlika između 120 milijardi i 20 milijardi parametara nije samo u veličini — manji model slabije zaključuje, ali radi na uređaju koji već imate.
Priča otvara pitanje koje zagovornici centralizirane umjetne inteligencije rado preskaču: ako se najveći otvoreni model može pokrenuti na telefonu, prijenosniku i dvije-tri radne stanice, čemu onda silna ulaganja u data centre i ovisnost o oblaku? Odgovor je jasan — brzina. Ali i ta brzina je stvar izbora i infrastrukture, a ne nepromjenjivog zakona.
Balkanski korisnici koji prate ovakve eksperimente trebaju imati na umu dvije stvari. Prvo, otvoreni modeli poput gpt-oss serije znače da pristup naprednoj umjetnoj inteligenciji više ne ovisi isključivo o američkim korporativnim serverima. Drugo, domaća rasprava o tehnološkoj autonomiji — o vlastitim podacima, vlastitoj infrastrukturi i vlastitom znanju — dobiva konkretan primjer da se može, makar sporo.
Ono što izostaje jest pitanje potrošnje energije i troška takvog eksperimenta. Šest uređaja koji danonoćno vrte model od 117 milijardi parametara troše struju kao manji ured. Dok se u Bruxellesu raspravlja o regulaciji umjetne inteligencije, građani sami, u svojim sobama, grade distribuirane sustave koje nitko ne registrira ni ne nadzire. To je i sloboda i rizik — ovisno o tome kome vjerujete da će povući prvi potez.
Dobro za znati, hvala na obavijest,i a i.nije loša ideja za stariji server sa 2TB memorije uz nove brze diskove obavit će posao cjelogodišnji rad instituta za aerodinamiku ili hidrodinamiku od prije 40 godina u dva dana i u potpunoj izolaciji što ne možeš dobiti na brzom cloudu. Bitno da je konačno proizvod kvalitetan i brz..
Genijalac.jbte . Meni au dao parametre da napravim ai na kućnom kompu sa jačom nvidijom i 1terabajt disk memorije. Istina da nema milijarde nečega al ai tvrdi da je za osobnu upotrebu bomba.