
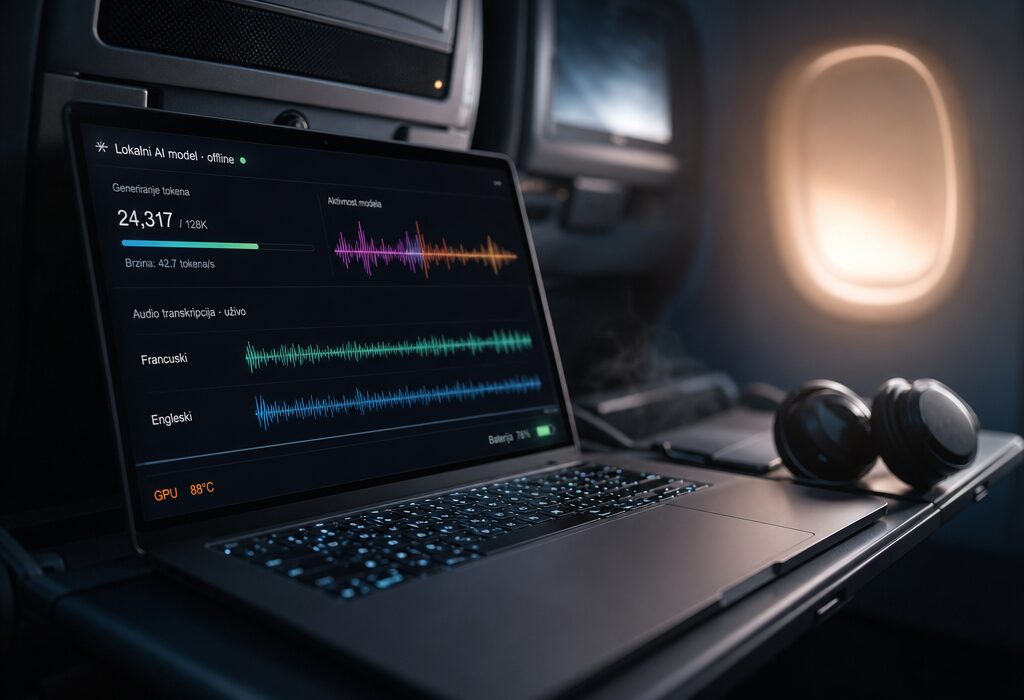
Lokalni AI modeli na prijenosnom računalu više nisu teorija — test na jedanaesterosatnom letu pokazao je da se ozbiljan rad s jezičnim modelima može odvijati potpuno bez interneta, bez pretplate i bez slanja podataka u oblak.
Asusovo prijenosno računalo s Nvidia RTX Spark čipom, koji spaja ARM procesor tajvanskog MediaTeka i Nvidiin grafički procesor, testirano je tijekom leta između San Francisca i Pariza u potpunoj mrežnoj izolaciji. Na konfiguraciji sa 64 GB radne memorije instalirano je nekoliko open-source modela, među njima kineski Qwen 3.6 s 35 milijardi parametara, koji je generirao 70 tokena u sekundi — brže od ljudskog čitanja.
Što lokalna obrada znači za korisnika
Noviji i optimiziraniji Qwen 3.8 sa 27 milijardi parametara spustio je brzinu na 16 tokena u sekundi, ali je točnost odgovora skočila na višu razinu. Zvučni i video zapisi transkribirani su lokalno pomoću Whisper Large V3 Turbo modela: sedamdeset sekundi materijala obrađeno je u šest sekundi, s automatskim prebacivanjem između francuskog i engleskog.
No test je razotkrio i granice. Kada su se pokušali povezati agentski model Hermes i generator slika Flux, 64 GB memorije pokazalo se nedovoljnim — nakon niza pogrešaka zbog zasićenja video memorije trebalo je smanjiti kontekst da bi se uopće generirala slika. Za složenije zadatke nužna je konfiguracija sa 128 GB.
Tu je i fizička strana: pri punom opterećenju prijenosno računalo postaje pravi radijator, a ventilatori na krilu ispuhuju vruć zrak koji postaje neugodan, dok se autonomija baterije topi pred očima.

0 komentara
Još nema komentara. Budite prvi.