
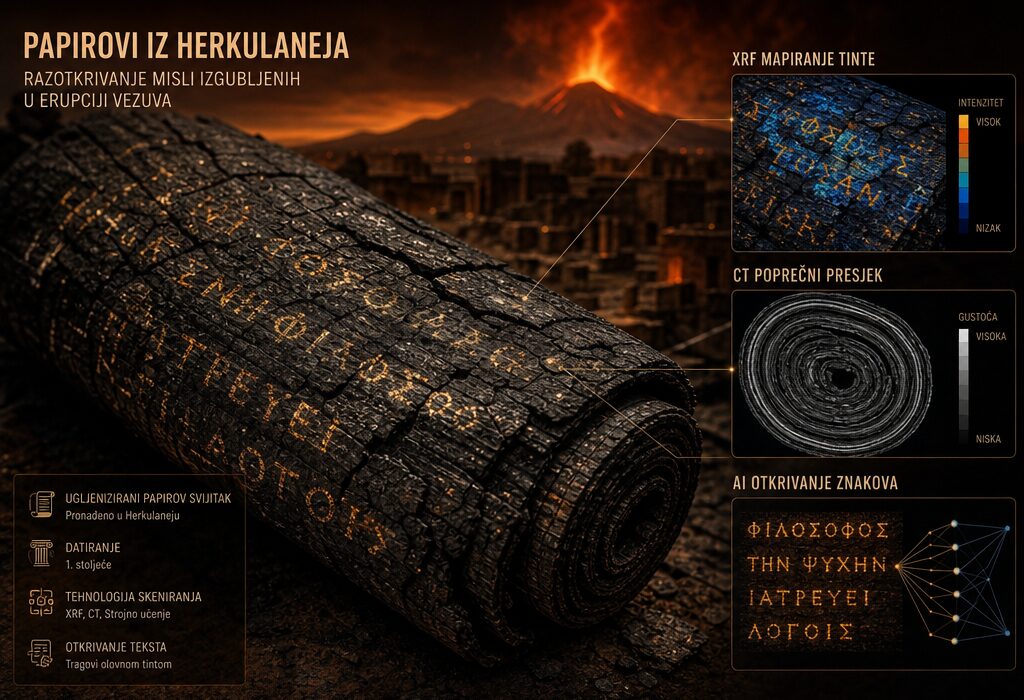
Znanstvenici su pronašli način da pročitaju antičke svitke koje je prije gotovo dvije tisuće godina spržila erupcija Vezuva — ali ta metoda otvara pitanje koje nitko ne postavlja: čemu služi znanje koje se ne može provjeriti.
Riječ je o Herculaneumskim papirusima, svitcima otkrivenima u ruševinama istoimenog grada pokraj Napulja. Tijekom erupcije 79. godine prekriveni su slojem kamena i pepela debljine 20 do 21 metra, a ekstremna ih je vrućina karbonizirala i učinila toliko lomljivima da se većina njih ne može fizički razmotati. Neki su ipak otvoreni i pročitani, otkrivši dotad nepoznate zapise Epikura i drugih antičkih mislilaca, no mnogi su ostali nedostupni.
Dosadašnji pristup oslanjao se na rendgensku tomografiju i umjetnu inteligenciju koja bi svitke virtualno „razmotavala“. Problem je u tome što rendgenske zrake teško razlikuju tekst od podloge — i tinta i papirus načinjeni su od ugljika, pa signal nema kontrast.
Olovo kao signal
Istraživački tim predvođen Douglasom Seilerom s kalifornijskog sveučilišta Berkeley krenuo je drugim putem. U nekim fragmentima herculaneumskih svitaka pronađeno je olovo, a budući da rendgen lako razlikuje olovo od papirusa, autori predlažu da se najprije skeniraju svitci u potrazi za olovom, a zatim virtualno razmotaju oni koji ga sadrže.
Kako bi to provjerili, tim je izradio vlastite karbonizirane svitke: pisali su na novi papirus tintom s različitim koncentracijama olova, a potom ih žarili u peći na visokoj temperaturi dok nisu pougljenili. Rendgenska fluorescencija detektirala je olovo na svakoj razini koncentracije, a tomografija u kombinaciji s posebnim softverom omogućila je čitanje dijela napisanih riječi. Rezultati su objavljeni u časopisu PLOS One.
Seilerova rečenica sažima ambiciju pothvata: „Nevjerojatno je što sve možete natjerati elektrone da rade.“
Algoritam koji uči od lažnjaka
Drugi dio priče možda je i važniji od prvoga. Umjetno stvoreni karbonizirani svitci mogu poslužiti kao trening za algoritme koji razmotavaju prave. Kad se zna što je unutra napisano, algoritam se može ispravljati dok ne pogodi točno — pa se ta sposobnost onda prenosi na antičke tekstove čiji sadržaj nitko ne zna.
To je metodološki ispravan put: prvo kontrolirani uzorak, pa nepoznanica. No upravo tu leži ono što izvještaj prešućuje. Algoritam koji je učio na suvremenoj tinti i suvremenom papirusu nije isto što i dvotisućljetni svitak koji je prošao kroz vulkansku kataklizmu. Svaki pročitani redak stoga dolazi s nevidljivom oznakom nepouzdanosti, a javnost će ga čitati kao citat iz antike.
Ne treba zaboraviti ni šire okruženje u kojem se ovo događa. Isti aparat — rendgen, tomografija, modeli strojnog učenja — danas se koristi i za nadzor, prepoznavanje lica i obradu podataka u industrijskim razmjerima. Tehnika je neutralna, ali njezina primjena nikada nije. Kad se jednom uspostavi cjevovod za „čitanje“ zatvorenih sadržaja bez otvaranja, on neće ostati ograničen na papirus iz Herculaneuma.
Pitanje koje nitko ne postavlja
Ako se virtualno razmotani tekst ne može provjeriti nikakvom neovisnom metodom — jer svitak je i dalje smotan i lomljiv — na temelju čega ćemo tvrditi da smo pročitali upravo ono što algoritam tvrdi? Znanstvena metoda počiva na ponovljivosti i mogućnosti opovrgavanja. Ovdje je ponovljiv samo kod, a ne izvor.
Herculaneumska knjižnica mogla bi nam vratiti izgubljena djela stoicizma, epikurejske fizike i rimske poezije. To je vrijedan cilj. Ali ako cijena bude navika da se rekonstrukcija iz algoritma prima kao izvorni tekst, dobili smo manje nego što smo izgubili — jer izgubljena knjiga je poštena nepoznanica, a lažno pročitana knjiga je trajna obmana.